Kurz gesagt: Die tragfähigen KI-Anwendungsfälle jenseits von Chatbots liegen dort, wo ein Unternehmen bereits eine strukturierte Historie besitzt: bei Angeboten, Absatzzahlen, Änderungsanträgen und Störmeldungen. Der Engpass ist dabei selten das Modell. Entscheidend sind die Verknüpfung zwischen den Systemen, konsistente Felddefinitionen über den gesamten Historienzeitraum und eine benannte Person, die das Ergebnis fachlich freigibt.
Chatbots sind für viele Industrieunternehmen der erste KI-Anwendungsfall, weil sie sichtbar sind und ohne tiefe Systemintegration auskommen. Die wirtschaftlich interessanteren Fälle beginnen danach: bei Angeboten, Absatzprognosen, technischen Änderungen und Störmeldungen. Sie haben eine gemeinsame Voraussetzung, an der sie auch scheitern: Die benötigten Daten müssen nicht nur vorhanden, sondern über Systemgrenzen hinweg nutzbar sein.
Die sichtbaren Fälle sind im Beitrag Wie KMU mit KI produktiver werden beschrieben: E-Mail-Triage, Angebots-Workflow, Wissensmanagement mit RAG, Reporting, Kundensupport, Marketing-Content, visuelle Qualitätskontrolle. Dieser Artikel behandelt die vier Fälle, die in Gesprächen mit datenintensiven Industrieunternehmen typischerweise erst in der zweiten Runde auf den Tisch kommen, weil sie tiefer in den Fachfunktionen liegen.
Die vier Use Cases auf einen Blick
| Use Case | Bereich | Business-Potenzial | Nötige Datenreife | Technische Komplexität | Risiko bei Fehlentscheidung | Als Erstpilot |
|---|---|---|---|---|---|---|
| Deal Support | Vertrieb | hoch | mittel | mittel | mittel (kommerziell) | ⭐ sehr gut geeignet |
| Forecasting | Planung, Controlling | hoch | hoch | hoch | mittel (Disposition) | bedingt geeignet |
| Change-Validierung | Engineering, Produktion | sehr hoch | sehr hoch | sehr hoch | hoch (Ausschuss, Gewährleistung) | anspruchsvoll |
| Incident-Bearbeitung | Technik, Service | hoch | mittel | mittel | hoch bei Sicherheitsrelevanz | ⭐ sehr gut geeignet |
Die Einstufungen in dieser Tabelle sind eine Einschätzung aus der Projektpraxis, keine Messwerte. „Nötige Datenreife” bezeichnet, wie weit die Quelldaten verknüpft und konsistent vorliegen müssen, bevor der Use Case überhaupt ein verwertbares Ergebnis liefern kann. „Technische Komplexität” bezieht sich auf die Zahl der anzubindenden Systeme und die Tiefe der nötigen Integration, nicht auf die Modellseite. „Business-Potenzial” beschreibt die Größenordnung des wirtschaftlichen Hebels, nicht seine Erreichbarkeit — Change-Validierung hat das höchste Potenzial und gleichzeitig die höchste Einstiegshürde. Eine menschliche Prüfung ist in allen vier Fällen vorgesehen; bei der Change-Validierung und bei sicherheitsrelevanten Störmeldungen ist sie zwingend und nicht über eine Konfidenzschwelle abkürzbar.
Ein Prinzip, das für alle vier Fälle gilt
Die vier Anwendungsfälle unterscheiden sich im Fachgebiet, folgen aber demselben Aufbau, und dieser Aufbau entscheidet darüber, ob das Ergebnis prüfbar ist:
- Deterministische Logik ermittelt alles, was vollständig sein muss. Datenbankabfragen mit eindeutigem Ergebnis gehören nicht in ein Modell.
- Ähnlichkeitssuche findet vergleichbare frühere Vorgänge und liefert eine Fallliste, keine Aussage.
- Das Sprachmodell fasst zusammen, gruppiert und formuliert. Es ergänzt keine Objekte, die nicht aus der deterministischen Abfrage stammen.
- Entschieden wird von Menschen, an einer definierten Stelle im Ablauf.
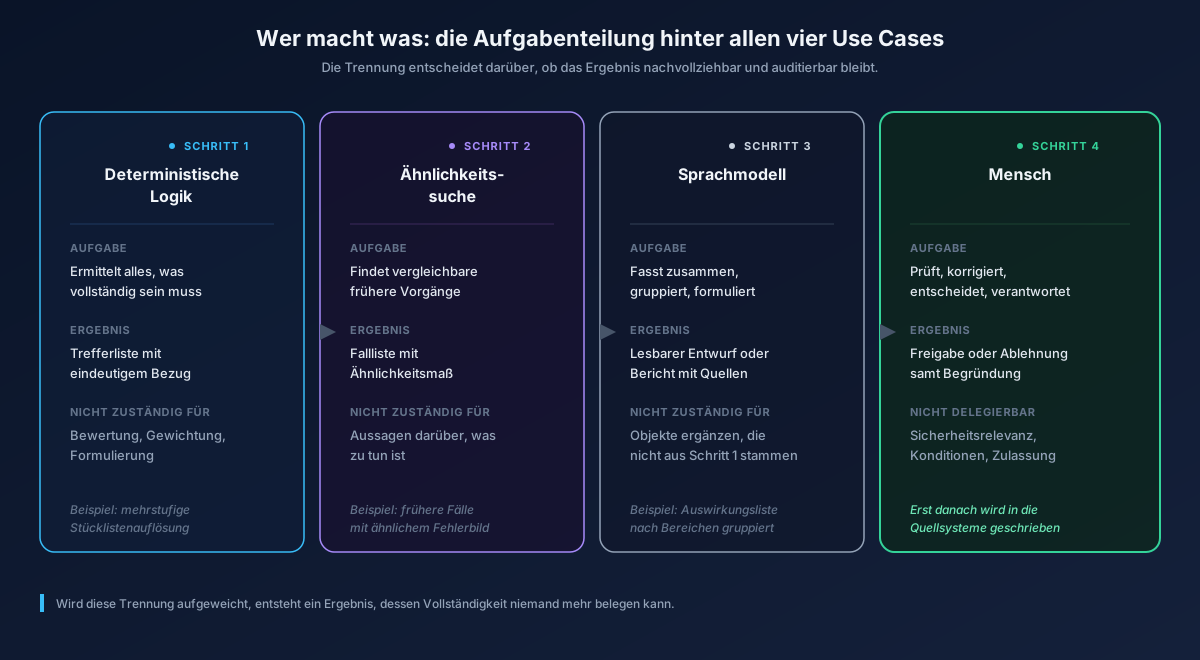
Wo diese Trennung aufgeweicht wird, entsteht ein Ergebnis, dessen Vollständigkeit niemand mehr belegen kann. Am ausführlichsten ist das unten am Beispiel der Change-Validierung beschrieben.
Jeder der vier Fälle ist im Folgenden nach demselben Muster beschrieben: was funktioniert, wo die Grenze liegt, welche Datenvoraussetzung erfüllt sein muss. Die Datenvoraussetzung steht bewusst in jedem Abschnitt. Sie ist der Punkt, an dem sich entscheidet, ob ein Use Case trägt.
Deal Support: Angebote und Kalkulationen beschleunigen, nicht automatisieren
Bereich: Vertrieb, Projektgeschäft
Wirtschaftlicher Hebel: Vertriebszeit pro Angebot und Kalkulationsqualität. Die zweite Größe ist die relevantere: Vergessene Positionen kosten in der Nachkalkulation mehr als ungenau geschätzte.
Im Projektgeschäft geht ein erheblicher Teil der Vertriebszeit nicht in den Verkauf, sondern in das Zusammensuchen von Grundlagen. Was haben wir bei einem vergleichbaren Projekt angesetzt? Welche Positionen standen in der Kalkulation? Welche Nebenleistungen sind damals durchgegangen, welche nicht? Diese Arbeit ist nicht komplex, aber verteilt: in Ordnerstrukturen, in CRM-Anhängen, im Erfahrungswissen einzelner Personen.
Was funktioniert
Entwurfserstellung aus Vergleichsprojekten. Der Vertrieb beschreibt die Anfrage in wenigen Sätzen oder wählt die relevanten Parameter aus. Das System sucht in der Historie nach Projekten mit ähnlichem Zuschnitt, extrahiert die dort verwendeten Positionen und erzeugt daraus einen Angebotsentwurf mit Quellenangabe: welches Vorgängerprojekt welche Position beigesteuert hat. Der Entwurf ersetzt nicht das Angebot. Er ersetzt die Suche nach den Vergleichsprojekten.
Die Quellenangabe ist dabei kein Komfortmerkmal, sondern die Bedingung dafür, dass der Use Case Zeit spart. Ein Entwurf ohne Herkunftsangabe zwingt die Vertriebsperson dazu, jede Position neu zu belegen. Ein Entwurf, bei dem hinter jeder Position das abgeschlossene Projekt steht, aus dem sie stammt, lässt sich Position für Position beurteilen.
Vorbefüllung von Kalkulationsvorlagen. Die Vorlage bleibt die bestehende. Gefüllt werden die Felder, die sich aus vergleichbaren Vorgängen ableiten lassen: Mengengerüst, Aufwandsansätze, Standardpositionen, typische Zuschläge. Felder ohne belastbare Grundlage bleiben leer und werden als offen gekennzeichnet. Eine leere, markierte Zelle ist besser als ein plausibel aussehender Wert ohne Herkunft, weil sie die Prüfung dorthin lenkt, wo sie gebraucht wird.
Was nicht funktioniert
Vollautomatischer Versand. Das ist keine Frage der Modellqualität, sondern der Struktur des Geschäfts.
Individuelle Konditionen sind selten vollständig in einem System hinterlegt. Rabattstaffeln, die für einen Kunden historisch gewachsen sind. Zahlungsziele aus einer Rahmenvereinbarung, die vom Standard abweichen. Zusagen zu Schulung, Inbetriebnahme oder Ersatzteilversorgung, die in einer E-Mail stehen und in keinem Stammdatensatz. Ein System, das diese Ebene nicht kennt, erzeugt Angebote, die formal korrekt und kommerziell falsch sind. Im Zweifel sind sie bindend.
Die Konsequenz ist strukturell, nicht technisch: Der Entwurf geht nie direkt nach außen. Es gibt einen Freigabeschritt mit einer namentlich verantwortlichen Person, und für jede Abweichung von der Standardkondition ein Pflichtfeld. Was nicht dokumentiert ist, wird nicht vorbefüllt.
Datenvoraussetzung
Eine strukturierte Historie abgeschlossener Angebote und Projekte an einem Zugriffspunkt. Das muss kein neues System sein, aber Angebot, zugehörige Kalkulation, Auftragsstand und Ergebnis müssen miteinander verknüpft abrufbar sein.
Typischer Befund
Ein wiederkehrendes Bild im Maschinen- und Anlagenbau: Angebote liegen als PDF im Dateisystem, die zugehörige Kalkulation als Excel-Datei im Nachbarordner, der Auftragsstand im ERP. Die einzige Verbindung zwischen den drei Beständen ist der Projektname, der in allen drei Systemen unterschiedlich geschrieben ist.
Der eigentliche Engpass ist dabei nicht die Suche über die PDF-Bestände. Der Engpass ist, dass sich einem Angebot nicht zuordnen lässt, ob das Projekt am Ende wirtschaftlich war. Ohne diese Zuordnung lernt das System, wie das Unternehmen kalkuliert hat, nicht, wo es richtig lag. Erst nachdem Angebot, Kalkulation und Projektergebnis über einen gemeinsamen Schlüssel verbunden waren, ließ sich der Use Case belastbar testen.
Nicht die KI-Lücke: die Suche über PDF-Bestände. Notwendige Vorarbeit: durchgängiger Projektschlüssel über Angebot, Kalkulation und Auftragsergebnis.
Forecasting: Absatz- und Kapazitätsplanung ohne Bauchgefühl
Bereich: Planung, Controlling, Disposition
Wirtschaftlicher Hebel: Bestandshöhe und Kapazitätsauslastung. Beide reagieren direkt auf die Prognosegüte, und beide sind im Unternehmen bereits messbar.
Absatz- und Kapazitätsplanung läuft in vielen Unternehmen über eine Kombination aus Vorjahreswerten, aktuellem Auftragsbestand und Erfahrung. Das trägt, solange die Rahmenbedingungen stabil sind, und wird unzuverlässig, sobald mehrere Effekte gleichzeitig wirken: Saisonalität, Kundenmix, Vorlaufzeiten, Sonderaktionen.
Was funktioniert
Prognoseverfahren auf Basis historischer und saisonaler Daten sind kein neues Thema, und das ist ihr Vorteil: Die Verfahren sind etabliert, die Fehlermaße definiert, die Ergebnisse gegen die tatsächliche Entwicklung überprüfbar.
Der Nutzen entsteht an drei Stellen:
- Absatzprognose auf der passenden Ebene statt pauschaler Steigerungsannahme über das gesamte Portfolio. Die Aggregation über alle Artikel verdeckt genau die Verschiebungen, die für die Disposition relevant sind. Welche Ebene sinnvoll ist — Einzelartikel, Produktgruppe, Kunde oder Werk —, hängt von Volumen und Nachfrageverhalten ab: Ein Forecast auf Einzelartikelebene wird bei vielen selten verkauften Varianten instabil, weil die Historie je Artikel zu dünn ist; auf Gruppenebene gehen dagegen genau die Verschiebungen zwischen Varianten verloren, die disponiert werden müssen. In der Praxis wird deshalb häufig auf zwei Ebenen prognostiziert und die feinere gegen die gröbere abgeglichen.
- Kapazitätsvorschau, die Auftragsbestand, Vorlaufzeiten und Saisoneffekte in einer Sicht zusammenführt, statt drei getrennte Sichten nebeneinanderzustellen.
- Abweichungsanalyse: die systematische Auswertung, wo die letzte Prognose danebenlag und welche Annahme dafür verantwortlich war.
Der dritte Punkt wird in Projekten häufig weggelassen, weil er nicht Teil des Planungsprozesses ist, sondern Teil seiner Nachbereitung. Ohne ihn weiß das Unternehmen zwar, dass der Forecast falsch lag, aber nicht, welche Annahmen systematisch korrigiert werden müssen. Konkret heißt Abweichungsanalyse nicht, dass ein Report die Differenz zwischen Plan und Ist ausweist. Sie heißt: Wenn die Prognose für ein Quartal 8.000 Einheiten ausgewiesen hat und tatsächlich 6.500 abgesetzt wurden, zeigt das System nicht nur die Lücke von 1.500 Einheiten, sondern die Artikelgruppen, in denen sie entstanden ist, und die Annahme, die dafür verantwortlich war — etwa eine Saisonkurve, die aus drei Vorjahren abgeleitet wurde, von denen eines eine Sonderaktion enthielt.
Ein Prognosemodell liefert außerdem etwas, das eine Schätzung nicht liefert: ein Maß für die eigene Unsicherheit. Eine Bandbreite mit ausgewiesener Streuung ist eine andere Entscheidungsgrundlage als eine einzelne Zahl.
Grenzen
Ein Modell kennt nur, was in den Daten steht. Es kennt nicht den Wettbewerber, der ein neues Werk in Betrieb nimmt, nicht die regulatorische Änderung, die eine Produktgruppe im kommenden Jahr betrifft, und nicht das Messegespräch, aus dem hervorgeht, dass ein Großkunde seine Beschaffung umstellt.
Diese Information liegt im Unternehmen, aber nicht in der Datenbank. Ein Forecast ersetzt deshalb keine Marktkenntnis. Er strukturiert die Ausgangsbasis und verschiebt die Planungsdiskussion von „Wie hoch schätzen wir?” zu „Welche Annahme weicht von der Datenlage ab, und warum?”. Der Gewinn ist also nicht die Prognosezahl, sondern die Tatsache, dass jede Korrektur an ihr begründet und dokumentiert wird. Genau diese Begründungen sind es, die ein Jahr später ausgewertet werden können.
Wo diese Trennung nicht eingehalten wird, entsteht ein bekanntes Muster: Das Modell wird so lange nachjustiert, bis es das Ergebnis liefert, das die Planung ohnehin vorgesehen hatte. Danach ist es kein Prognoseinstrument mehr, sondern eine Begründung für eine bereits getroffene Entscheidung.
Datenvoraussetzung
Konsistente Ist-Zahlen aus ERP und BI, keine Silodaten. Konkret: Absatzmengen, Umsätze, Auftragseingänge und Kapazitätsdaten liegen über einen ausreichend langen Zeitraum in einer Definition vor, die sich in diesem Zeitraum nicht stillschweigend geändert hat.
Typischer Befund
Der Stolperstein ist in der Regel nicht die fehlende Zahl, sondern die stille Umdefinition. Eine Artikelgruppe wird neu geschnitten, ohne dass die Historie mitgezogen wird. Der Umsatzbegriff ist in der Vertriebssicht anders gefasst als im Controlling. Ein Werk bucht seit einer Systemumstellung anders als vorher.
Für das Modell sind das Strukturbrüche, die wie Marktereignisse aussehen. Es lernt einen Absatzeinbruch, der keiner war, und trägt ihn als Saisoneffekt in die Zukunft fort. Auffällig wird das nicht im Training, sondern erst, wenn die Fachabteilung die Prognose sieht und sagt, dass dieses Jahr nie so schlecht war.
Wie sich das grundsätzlich auflösen lässt, beschreibt der Beitrag Single Point of Truth im Mittelstand.
Nicht die KI-Lücke: die Wahl des Prognoseverfahrens. Notwendige Vorarbeit: dokumentierte Felddefinitionen und markierte Strukturbrüche über den gesamten Historienzeitraum.
Change-Validierung: Auswirkungen einer technischen Änderung vorprüfen
Bereich: Engineering, Produktion, Qualität
Wirtschaftlicher Hebel: Ausschuss und Nacharbeit durch übersehene Auswirkungen sowie die Durchlaufzeit des Änderungsprozesses. Der erste Posten ist der größere, taucht aber in keiner Prozesskennzahl auf, weil er als Qualitätsproblem gebucht wird.
Technische Änderungen sind der Punkt, an dem Engineering und Produktion aufeinandertreffen. Eine Änderung an einem Bauteil zieht Konsequenzen über mehrere Systeme und Abteilungen nach sich: Stückliste, Fertigungsplanung, Prüfvorschrift, Lieferantenfreigabe, Dokumentation, teilweise Kundenfreigabe.
Das Problem ist dabei selten, dass die Konsequenzen unbekannt wären. Das Problem ist, dass sie sequenziell und manuell ermittelt werden. Der Änderungsantrag wandert durch die Gremien, jede Abteilung prüft ihren Ausschnitt, und die Rückfragen entstehen einzeln statt gebündelt. Der Durchlauf ist deshalb lang, weil die Prüfung verteilt stattfindet, nicht weil sie aufwendig wäre.
Was funktioniert
Eine Vorprüfung, die vor der Gremienentscheidung durchläuft und die Auswirkungen bündelt. Konkret:
- Stücklistenanalyse: In welchen Baugruppen und Erzeugnissen ist das geänderte Teil verbaut, auch mehrstufig? Welche laufenden Aufträge und welche Bestände sind betroffen?
- Fertigungsbezug: Welche Arbeitspläne, Werkzeuge, Vorrichtungen und Prüfschritte referenzieren das Teil?
- Qualitätsbezug: Existieren Prüfvorschriften, Erstmusterprüfberichte oder Freigaben, die durch die Änderung ungültig werden?
- Dokumentation: Welche Zeichnungen, Betriebsanleitungen, Ersatzteillisten und Kundendokumente enthalten den geänderten Stand?
- Ähnliche Vorgänge: Welche früheren Änderungen an vergleichbaren Teilen gab es, und welche Nacharbeiten waren dort nötig?
Der letzte Punkt ist der, den ein rein regelbasiertes System nicht liefert. Die ersten vier sind Abfragen über verknüpfte Strukturen; der fünfte erfordert eine Ähnlichkeitssuche über unstrukturierte Beschreibungstexte abgeschlossener Änderungsanträge.
Das Ergebnis ist keine Entscheidung, sondern eine strukturierte Auswirkungsliste, die dem Änderungsverantwortlichen in der Sitzung vorliegt, statt über zwei Wochen eingesammelt zu werden. Dieser Use Case zielt damit auf zwei messbare Größen: die Zeit von der Antragstellung bis zur vollständigen Auswirkungsanalyse und die Zahl der betroffenen Objekte, die erst nach der Entscheidung entdeckt werden. Beide lassen sich vorher und nachher erheben.
Wie so ein System aufgebaut ist
Genau hier lohnt es, konkret zu werden, weil die Aufgabenverteilung zwischen klassischer Logik und Modell darüber entscheidet, ob das Ergebnis prüfbar ist.
Die Aufgabenverteilung im Einzelnen:
- Klassische, deterministische Logik ermittelt die betroffenen Objekte. Verwendungsnachweis, Stücklistenauflösung, Bestands- und Auftragsbezug sind Abfragen mit eindeutigem Ergebnis. Sie gehören nicht in ein Modell, weil ein Modell hier nichts hinzufügt und Vollständigkeit nicht garantieren kann.
- Ähnlichkeitssuche (Vektorsuche über Beschreibungstexte und Änderungsgründe) findet vergleichbare frühere Vorgänge. Ergebnis ist eine Liste von Fällen mit Ähnlichkeitsmaß, keine Aussage.
- Das Sprachmodell fasst zusammen, gruppiert nach Auswirkungsbereich und formuliert den Report. Es bewertet nicht, ob eine Änderung freigegeben werden kann, und es ergänzt keine betroffenen Objekte, die nicht aus der deterministischen Abfrage stammen.
- Nie durch das Modell entschieden wird die Freigabe selbst, die Einstufung der Änderungsklasse, die Frage der Kunden- oder Lieferantenfreigabepflicht und jede sicherheits- oder zulassungsrelevante Bewertung.
- Human-in-the-loop sitzt an genau einer Stelle: vor der Entscheidung. Der Report ist Eingangsmaterial für das Gremium, nicht dessen Ersatz.
- Lesend und schreibend: Alle Quellsysteme werden ausschließlich lesend angebunden. Geschrieben wird erst nach der menschlichen Entscheidung, und geschrieben wird die Entscheidung samt Begründung, nicht der Modellvorschlag.
Diese Trennung ist auch der Grund, warum der Use Case auditierbar bleibt. Jede Position im Report lässt sich auf eine Datenbankabfrage zurückführen, jede Ähnlichkeitsangabe auf einen konkreten früheren Vorgang.
Warum das für Industrieunternehmen relevant ist
Änderungsprozesse haben eine Eigenschaft, die sie von den meisten anderen Automatisierungskandidaten unterscheidet: Ihre Fehlerkosten sind asymmetrisch. Eine zu lange Durchlaufzeit kostet Zeit und bindet Kapazität. Eine übersehene Auswirkung kostet Ausschuss, Nacharbeit, Rückrufe oder Gewährleistung.
Gleichzeitig liegt hier häufig die Naht der Systemlandschaft: PLM auf der Engineering-Seite, ERP auf der Produktionsseite, Qualitätsmanagement teilweise in einem dritten System, Dokumentation im Dateisystem. Jede Abteilung arbeitet sauber in ihrem System, und die Brüche verlaufen genau entlang des Änderungsprozesses. Der Use Case ist deshalb inhaltlich attraktiv und technisch anspruchsvoll: Er setzt an der Stelle an, die sonst niemand anfasst.
Datenvoraussetzung
Verknüpfte PLM- und ERP-Daten. Nicht zwingend ein gemeinsames System, aber eine eindeutige Teileidentität, die von der Konstruktionsseite bis in Arbeitsplan, Bestand und Prüfvorschrift verfolgbar ist.
Fehlt diese Identität, kann das Regelwerk betroffene Arbeitspläne und Bestände nicht vollständig ermitteln. Eine Auswirkungsliste, die einen Teil der Verwendungen nicht enthält, ist dann gefährlicher als gar keine, weil sie Vollständigkeit suggeriert und der Prüfschritt sich auf sie verlässt. In diesem Zustand ist der Use Case nicht produktionsreif, unabhängig davon, wie gut der Rest funktioniert.
Nicht die KI-Lücke: die Erzeugung des Reports. Notwendige Vorarbeit: eindeutige, systemübergreifende Teileidentität zwischen PLM, ERP und Qualitätsmanagement.
Incident-Bearbeitung: Störungen vorklassifizieren und aus Fällen lernen
Bereich: Technik, Service, Instandhaltung
Wirtschaftlicher Hebel: Liegezeit bis zur ersten fachlichen Bearbeitung, First-Time-Fix-Quote und die Zahl wiederkehrender Fehler, die als Einzelfälle bearbeitet werden.
Technische Störmeldungen aus der eigenen Produktion oder aus dem Feld wiederholen sich. Nicht identisch, aber in Mustern. Weil Fehlerbilder wiederkehren und abgeschlossene Fälle dokumentiert vorliegen, lässt sich eine neue Meldung gegen die Fallhistorie abgleichen. Das Erfahrungswissen, das heute an einzelne Techniker gebunden ist und mit ihnen das Unternehmen verlässt, wird dadurch abfragbar.
Was funktioniert
Vorklassifizierung. Eingehende Meldungen werden nach Anlage oder Produkt, Fehlerbild, Dringlichkeit und zuständigem Bereich eingeordnet und mit den Stammdaten des betroffenen Objekts angereichert. Das spart nicht die Bearbeitung, sondern den Weg dorthin: Die Meldung landet bei der zuständigen Stelle, mit dem Kontext, der sonst erst erfragt wird.
Der Hebel liegt hier deshalb hoch, weil in der Störungsbearbeitung ein großer Teil der Gesamtdauer auf Liegezeiten entfällt, nicht auf Bearbeitungszeit. Ob das auch bei Ihnen so ist, lässt sich vorab prüfen: Vergleichen Sie in Ihrem Ticketsystem den Zeitstempel des Eingangs mit dem der ersten fachlichen Bearbeitung. Ist die Differenz groß, ist die Vorklassifizierung der richtige Ansatzpunkt. Ist sie klein, liegt der Engpass woanders und dieser Use Case bringt wenig.
Vorschläge aus ähnlichen Fällen. Zu einer neuen Meldung werden abgeschlossene Fälle mit ähnlichem Fehlerbild angezeigt, mit der damals durchgeführten Maßnahme und dem Ergebnis. Der Techniker sieht keine Empfehlung, sondern eine Fallhistorie, die er beurteilen kann. Auch hier ist die Herkunftsangabe das entscheidende Gestaltungsmerkmal: Ein Vorschlag ohne Quelle wird entweder ungeprüft übernommen oder ignoriert.
Auswertung über die Fallbasis. Häufungen, die in der Einzelbearbeitung nicht auffallen, werden über die Gesamtheit sichtbar: eine Fehlerart, die seit einer Chargenumstellung häufiger auftritt, eine Baugruppe, die in einer bestimmten Einbausituation überproportional ausfällt. Das ist kein Bearbeitungs-, sondern ein Verbesserungsnutzen, und oft der nachhaltigere.
Grenze
Bei sicherheitskritischen Vorfällen bleibt der Mensch in der Entscheidungskette, ohne Ausnahme und ohne Abkürzung über eine Konfidenzschwelle. Das betrifft alles, was Personensicherheit, Anlagensicherheit, Produktsicherheit oder Meldepflichten berührt.
Praktisch bedeutet das eine Zweiteilung im Systemdesign: Es gibt eine definierte Klasse von Meldungen, bei denen das System ausschließlich vorbereitet und anreichert, aber nichts abschließt, nichts in der Priorität herunterstuft und nichts automatisch schließt. Diese Klasse wird vor der Einführung festgelegt, nicht nachträglich aus Vorfällen abgeleitet.
Die zweite Grenze ist subtiler: Ein System, das aus der Historie lernt, reproduziert die Klassifikationsfehler der Historie. Wurde eine Störungsart über Jahre falsch eingeordnet, wird sie weiterhin falsch eingeordnet, nur schneller und mit dem Anschein von Systematik. Deshalb gehört eine regelmäßige Auswertung der Fälle, in denen die Vorklassifizierung manuell korrigiert wurde, zum Betrieb und nicht zum optionalen Reporting.
Datenvoraussetzung
Eine strukturierte, durchsuchbare Ticket- und Störfallhistorie. Entscheidend ist weniger die Menge als die Qualität des Abschlusses: Was wurde gemacht, was war die Ursache, hat es gewirkt?
Typischer Befund
Der Abschlussdatensatz ist in vielen Ticketsystemen das schwächste Feld, weil er am Ende der Bearbeitung steht, wenn der Fall gedanklich erledigt ist. Der häufigste Abschlusstext lautet sinngemäß „Fehler behoben”.
Für den Piloten hat das eine unangenehme Konsequenz: Die Ticketmenge ist groß genug, die verwertbare Wissensbasis nicht. Die Vorklassifizierung funktioniert trotzdem, weil sie hauptsächlich aus Meldungstext und Stammdaten arbeitet. Die Fallvorschläge funktionieren nicht, weil ein Fall ohne dokumentierte Maßnahme keinen Vorschlag ergibt.
Die Reihenfolge ist deshalb: erst den Abschlussdatensatz überarbeiten, so knapp, dass er ausgefüllt wird, und so strukturiert, dass er auswertbar ist. Dann sammeln. Dann den Use Case bauen. Das ist unbefriedigend, weil der Nutzen erst nach einigen Monaten Sammelzeit eintritt, aber die Abkürzung existiert nicht.
Nicht die KI-Lücke: die Ähnlichkeitssuche über Fehlerbilder. Notwendige Vorarbeit: standardisierter Abschlussdatensatz mit Ursache, Maßnahme und Wirksamkeit.
Der gemeinsame Nenner: ohne Datenbasis kein tragfähiger Use Case
Vier Anwendungsfälle aus vier Funktionsbereichen, und in jedem steht der begrenzende Faktor an derselben Stelle. Nicht beim Modell, nicht beim Tool, nicht beim Budget, sondern bei der Frage, ob die benötigten Daten verknüpft, konsistent und ausreichend vollständig vorliegen.
| Use Case | Begrenzender Faktor | Art des Problems |
|---|---|---|
| Deal Support | Verknüpfung von Angebot, Kalkulation und Projektergebnis | Verknüpfung zwischen Systemen |
| Forecasting | Konsistente Definitionen über den Historienzeitraum | Semantik und Dokumentation |
| Change-Validierung | Durchgängige Teileidentität von PLM bis ERP und QM | Verknüpfung zwischen Systemen |
| Incident-Bearbeitung | Qualität der Abschlussdokumentation | Prozess und Erfassung |
Keiner dieser Punkte ist ein KI-Thema. In zwei von vier Fällen ist es eine Frage der Verknüpfung zwischen Systemen, in einem eine Frage der Definitionen, in einem eine Frage des Erfassungsprozesses. Die reine Menge der Daten ist in keinem der vier Fälle der entscheidende Engpass. Sie ist allerdings eine zusätzliche Bedingung: Ein Forecast braucht eine ausreichend lange Historie, um Saisonalität überhaupt schätzen zu können, und eine Fallsuche braucht eine ausreichende Zahl verwertbarer abgeschlossener Fälle. Diese Bedingung ist in der Regel erfüllt, sobald die Verknüpfungs- und Definitionsfragen geklärt sind.
Daraus folgt eine Reihenfolge, die in der Praxis unbequem ist, weil sie die vorzeigbaren Ergebnisse nach hinten schiebt: Erst wird geklärt, welcher Use Case den größten Wert hätte. Dann wird geprüft, welche Datenbasis er voraussetzt und wie weit sie vorhanden ist. Dann wird die Lücke geschlossen, so eng wie möglich am Use Case. Erst dann wird gebaut.
Der umgekehrte Weg, erst das System und dann die Daten, erzeugt ein vorführbares Ergebnis und ein Folgeproblem. Warum diese Reihenfolge nicht verhandelbar ist und wie eine Datenstrategie aussieht, die nicht als Dokument endet, steht im Beitrag Datenstrategie vor KI-Strategie.
Zur Einordnung dieses Artikels: Die hier beschriebenen Muster stammen aus der Projektpraxis und aus Gesprächen mit Industrieunternehmen. Sie sind keine Studienergebnisse, und die Einstufungen in der Auswahlmatrix sind Einschätzungen, keine Messwerte. Wo in diesem Artikel keine Zahl steht, steht bewusst keine: Belastbare, branchenübergreifende Quantifizierungen für Anwendungsfälle dieser Art sind uns nicht bekannt, und geschätzte Prozentwerte wären an dieser Stelle Scheingenauigkeit. Wenn Sie für Ihr Unternehmen eine Zahl brauchen, ist der verlässlichste Weg die Messung im eigenen Prozess: Durchlaufzeit vorher und nachher, Fehler- beziehungsweise Nacharbeitsquote vorher und nachher.
Wie Sie den passenden Use Case auswählen
Vier Fragen, die sich in einem Termin mit den betroffenen Fachbereichen beantworten lassen:
- Wo entsteht die meiste Wartezeit? Nicht die meiste Arbeit, sondern die meiste Zeit, in der ein Vorgang liegt und auf eine Zuordnung, eine Information oder eine Freigabe wartet. Diese Zeit lässt sich in den meisten Systemen über Zeitstempel auslesen.
- Existiert für diesen Vorgang eine dokumentierte Historie? In welcher Form, über welchen Zeitraum, und ab wann ist sie konsistent? Der Beginn der Konsistenz ist oft die letzte Systemumstellung, nicht der Beginn der Datenhaltung.
- Gibt es eine benannte Person, die das Ergebnis fachlich verantwortet? Ohne diese Rolle entsteht ein Vorschlag, den niemand freigibt.
- Was passiert im schlechtesten Fall, wenn das System falsch liegt? Diese Frage entscheidet über die Gestaltung: Vorschlag mit Einzelfreigabe, Vorschlag mit Vier-Augen-Prinzip, oder dieser Vorgang gar nicht.
Die vier Fragen ersparen die Situation, dass sechs Wochen nach Projektstart auffällt, dass die benötigte Historie erst seit der letzten Systemumstellung existiert.
Nächster Schritt
Wenn Sie einschätzen wollen, welcher dieser Anwendungsfälle in Ihrem Unternehmen tragfähig ist und wo die Datenbasis dafür heute steht, gibt es drei Wege:
- Datenreife-Check anfragen — eine strukturierte Einschätzung Ihrer Datenlage, inklusive der Frage, welcher Use Case auf dieser Basis realistisch ist. Auch dann, wenn die ehrliche Antwort lautet, dass zuerst aufgeräumt werden muss.
- Strategy Sprint — zwei Wochen, senior-geführt, mit einer investitionsreifen Entscheidungsvorlage am Ende: welcher Use Case, in welchem Zuschnitt, mit welcher Vorarbeit.
- KI-Agenten-Lösung — die Umsetzung, wenn Use Case und Datenbasis geklärt sind.